深度学习个人笔记分享
分享一些个人在学习过程中的笔记。
参考资料:
机器学习基础理论 & 为什么选择深度学习
basic-thoery-of-ml-why-deep.pdf|attachment (483.5 KB)
机器学习框架及一些问题的解决
frame-fix.pdf|attachment (1007.5 KB)
卷积神经网络
CNN.pdf|attachment (1.8 MB)
自注意力机制与 Transformer
对比学习综述
constrastive-learning.pdf|attachment (1.4 MB)
good
自黄药师黄仁勋来,世人皆爱猫。余独爱老鼠之,可爱之态,活泼之动,实为人所难以抗拒。喵~
 🐁 🐁 🖱️ 🪤
好好好,狠狠支持了 🥳 不知道我大二暑假能不能用到 😰
年月擦身过,暂且问,会更好吗?
好强 😳
杂项
会持续更新
正则化
Weight Decay - L2 正则项
we multiply the sum of squares with another smaller number. This number is called weight decay or wd.
Our loss function now looks as follows:
Loss = MSE(y_hat, y) + wd * sum(w^2)
减小模型复杂度(弹性),降低过拟合的概率
残差(residual)和残差网络
CNN 输出大小公式
为输入大小, 为卷积核大小, 为填充大小(Padding), 为步长(Stride), 为输出大小,则有:
熵(Entropy);KL 散度(KL Divergence)
熵
若一个离散随机变量 的可能取值为 ,而对应的概率为 ,则随机变量 的熵定义为:
交叉熵
针对上述离散变量的概率分布 而言,其交叉熵定义为:
在信息论中,交叉熵可认为是对预测分布 用真实分布 来进行编码时所需要的信息量大小。
KL 散度(KL Divergence)
KL 散度可以用来衡量两个分布之间的差异:
交叉熵损失函数实际上就是 KL 散度,只不过因为分类问题的特殊性,其式与交叉熵相同:
在分类问题中,我们通过 softmax 函数得到一个分布,我们要通过 KL 散度 衡量这个分布和目标分布(一个 one-hot 向量)的差异性:
我们易知 ;且对于真实分布(一个 one-hot 向量)只有概率为 1 的一项是非 0 的,所以有以下化简:
KL 散度的数学性质
- 正定性
- 不对称性
KL 散度并不是一个真正的度量或者距离,因为它不具有对称性:
JS 散度(JS Divergence)
JS 散度 度量了两个概率分布的相似度,基于 KL 散度 的变体,解决了 KL 散度 非对称的问题。一般地,JS 散度 是对称的,其取值是 0 到 1 之间。
对于 JS 散度,当两个分布完全不重合时,JS 散度始终为 1()
这课看着很不错诶。我也来学一学吧。
我似乎没寻找到他作业如何发布的,莫非是 private 吗?
 hoist
李宏毅的课吗,作业就在课程主页下面。个人认为他的课程坡度还是挺大的,光听不练/不记笔记感觉还是差点。每一年作业基本都是一样的,2022 的做的不好可以试试 2021,2023 的。
 TsuinoSora
我基本是他的课和他的作业和李沐的带读论文一起进行,中途还有无数次专门去找资料学习某个小知识。
真强
GAN
GAN.pdf|attachment (3.7 MB)
Pytorch 要学多少学到哪里才能入门这个课呀
 白车草
会基础的 Python 语法,遇到啥不会的直接搜索就能入门。
另外不写作业的话一点代码都不写也没学
我看这课 ML 2023 全部改成了生成式 AI、是觉得会全面迭代技术吗?你对此什么看法。
另外我对这课程无比佩服,竟然能大幅度调整大纲
hoist 李宏毅老师的课跟热点跟的很勤。一直都是每年开课根据过去一年的 AI 发展较大幅度的更改大纲,提供比较新的技术。比如 RNN 自从 Transformer 大范围使用后就变成了选学内容,学生想学去看之前的录像就好了。
2023 的版本虽然作业还是沿着 Regression -> CNN -> Attention 来的,但是上课内容基本全是生成式 AI,老师基本默认了不会走“回头路”一般。你们学生不会做作业那就看我以前上课的录像好了。
再看今年 2024 老师开得课,直接没有 ML 课了,改成叫 GENERATIVE AI 了。他可能觉得讲过的不必再讲一遍吧。
Bert & GPT
BERT-GPT.pdf|attachment (1.4 MB)
MAE
MAE.pdf|attachment (398.1 KB)
Clip
CLIP.pdf|attachment (640.3 KB)
文献应该怎么读?读多少算读完一篇文章了。像这篇 clip 我把正文逐字逐句读过去了,然而没有看他的代码。之前的 MAE,我看他基本就是把 Bert 套用过来,就很简略的读了下(只读了方法没有读实验)。
SAM (Segment Anything)
segment-anything.pdf|attachment (1.9 MB)
Swin Transformer
Swin-Transformer.pdf|attachment (1.6 MB)
TsuinoSora 这个怎么样啊
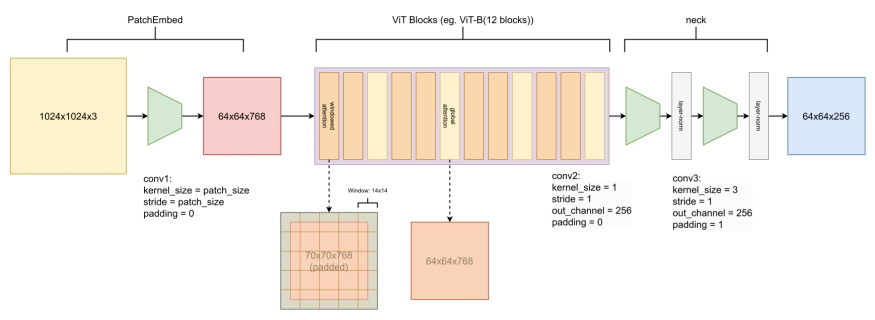
好不容易自己对着源码画了个图 hhh 在网上好像不太找得到这样详细的 sam image encoder 图就分享下(
TsuinoSora 学学 prompt engineering。
Large Language Models Are Human-Level Prompt Engineers
TsuinoSora 说到 LLM,微软这两天发布了新一代的轻量级模型 Phi-3 3.8B/7B/14B,并且特别强调通过筛选高质量数据提升小模型的逻辑推理能力。他们在筛选数据时,会筛去相当多能提供知识但对推理帮助不大的数据,相当于是主动舍弃部分知识储备来换取更强的逻辑,并且解释说小模型配合搜索引擎也可以工作得很好。
(以上信息大体来自近期看过的公众号,不保证完全准确)
門友喜欢大模型多一点还是小模型多一点?当然这个观点也不是绝对的,比如 Phi-3 的训练数据中有不少是更大的模型生成的(并且微软好像认为它们比部分来自真人的数据更好)。
 greyishsong
我只能说,我最近的工作本来在 phi-2 上做魔改,现在瞌睡来了送枕头,明天和 mentor 开会,狠狠改 phi-3
Ch0102 笔记.pdf|attachment (3.1 MB)
借楼,小学期办了个深度学习讨论班,指导老师推荐用书是
Deep Learning - Foundations and Concepts (bishopbook.com)
每攒两章就在里发笔记,算是自我监督了
(要是有同学发现哪里有错,可以留言提醒我修改)
年月擦身过,暂且问,会更好吗?
TsuinoSora 这种图是用什么软件画的?Draw.io 吗?
 玉米🌽
2023 年的新书。
 小王在上海
感觉很像啊,我也经常用 draw.io 画图,这个看起来和它的默认配色方案一模一样
小王在上海 是的
请问笔记时用什么整理的呢
markdown
或者 notion
MyVLM
MyVLM.pdf|attachment (1.8 MB)