Andrej Karpathy - 2025 LLM Year in Review
2025 年 LLM 年度回顾
作者:Andrej Karpathy
2025 年是大型语言模型(LLM)进步强劲且充满事件的一年。以下是我个人认为值得注意且有些令人意外的“范式变革”列表——这些变革改变了整个格局,并在概念上让我印象深刻。
1. 来自可验证奖励的强化学习(RLVR)
在 2025 年初,所有实验室的 LLM 生产流程大致如下:
-
预训练(类似于 2020 年的 GPT-2/3)
-
监督微调(InstructGPT,约 2022 年)
-
来自人类反馈的强化学习(RLHF,约 2022 年)
这曾经是训练生产级 LLM 的稳定且经过验证的配方。在 2025 年,来自可验证奖励的强化学习(RLVR)成为新增的主要阶段,成为事实上的新标准。通过在多个环境中(例如数学/代码谜题)针对自动可验证的奖励训练 LLM,LLM 会自发发展出人类看来像“推理”的策略——它们学会将问题解决分解为中间计算,并学会多种问题解决策略,来回迭代以找出答案(参见 DeepSeek R1 论文中的例子)。在之前的范式中,这些策略很难实现,因为不清楚 LLM 的最优推理轨迹和恢复过程是什么样子——它必须通过针对奖励的优化自己找出有效的方法。
与 SFT 和 RLHF 阶段不同(两者都是相对较短的微调阶段,计算量较小),RLVR 涉及针对客观(不可作弊)的奖励函数进行训练,这允许进行更长的优化。事实证明,运行 RLVR 提供了很高的能力/成本比,它吞噬了原本打算用于预训练的计算资源。因此,2025 年的大部分能力进步来自于 LLM 实验室消化这个新阶段的计算过剩,我们看到了规模大致相同的 LLM,但 RL 运行时间更长。此外,这个新阶段独有的特点是,我们获得了一个全新的控制旋钮(以及相关的缩放定律),可以通过生成更长的推理轨迹并增加“思考时间”来控制能力,作为测试时计算的函数。OpenAI o1(2024 年末)是 RLVR 模型的首次演示,但 o3 发布(2025 年初)是明显的拐点,你能直观感受到差异。
2. 鬼魂 vs. 动物 / 锯齿状智能
2025 年是我(以及我认为整个行业)第一次开始更直观地内化 LLM 智能的“形状”。我们不是在“进化/培养动物”,而是在“召唤鬼魂”。LLM 栈的一切都不同(神经架构、训练数据、训练算法,尤其是优化压力),因此我们得到的情报空间中的实体完全不同,用动物的视角来思考它们是不合适的。从监督信号的角度看,人类神经网络优化的是部落在丛林中的生存,而 LLM 神经网络优化的是模仿人类的文本、在数学谜题中收集奖励,以及在 LM Arena 上获得人类点赞。由于可验证领域允许 RLVR,LLM 在这些领域附近的能力会“突增”,整体表现出有趣的锯齿状性能特征——它们同时是天才通才和困惑的、认知受限的小学生,随时可能被越狱技巧欺骗而泄露你的数据。
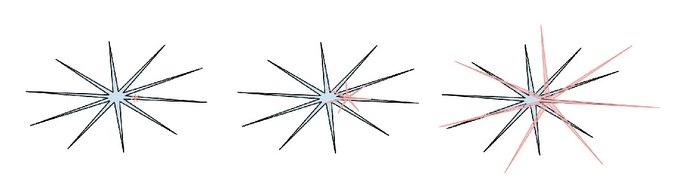
人类智能:蓝色,AI 智能:红色。我喜欢这个模因的这个版本(抱歉,我丢失了原帖在 X 上的引用),它指出了人类智能也以自己的方式是锯齿状的。
与此相关的是,我在 2025 年对基准测试的普遍冷漠和信任丧失。核心问题是,基准测试几乎本质上就是可验证环境,因此立即容易受到 RLVR 和其较弱形式(如合成数据生成)的影响。在典型的“benchmaxxing”过程中,LLM 实验室的团队不可避免地在基准测试占据的嵌入空间小区域附近构建环境,并生长出锯齿来覆盖它们。在测试集上训练成了一种新艺术形式。
碾压所有基准但仍未达到 AGI 会是什么样子?
我在此主题上写了更多内容:
3. Cursor / LLM 应用的新层级
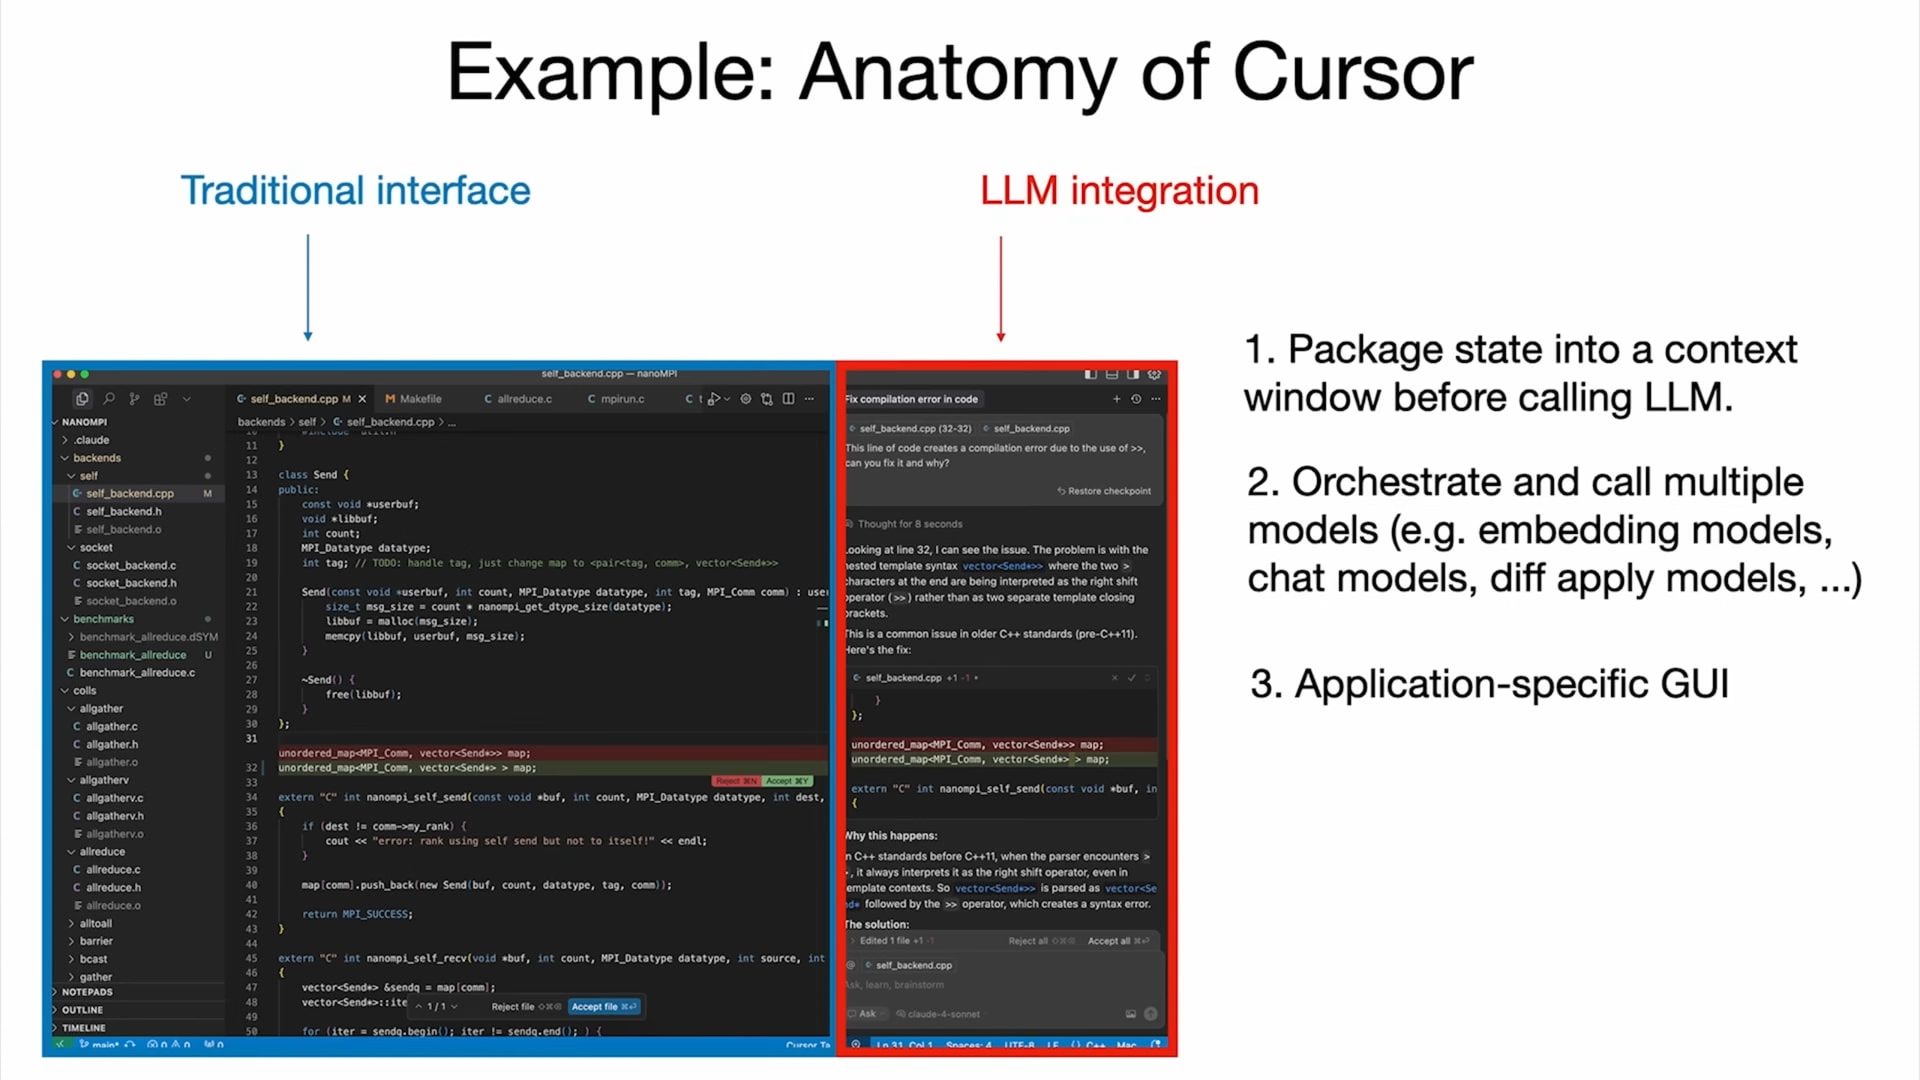
Cursor 最值得注意的地方(除了它今年的迅猛崛起之外)是,它令人信服地揭示了“LLM 应用”的新层级——人们开始谈论“Cursor for X”。正如我在今年 Y Combinator 演讲中强调的(演讲稿 和 视频),像 Cursor 这样的 LLM 应用为特定垂直领域捆绑和编排 LLM 调用:
-
它们进行“上下文工程”
-
它们在底层编排多个 LLM 调用,串成越来越复杂的 DAG,仔细平衡性能和成本权衡。
-
它们为人类交互提供特定应用的 GUI
-
它们提供“自治滑块”
2025 年有很多讨论集中在这一新应用层级的“厚度”上。LLM 实验室会捕获所有应用,还是 LLM 应用有广阔的绿地?就我个人而言,我怀疑 LLM 实验室会倾向于培养通用能力的大学生,但 LLM 应用会通过提供私有数据、传感器和执行器以及反馈循环,来组织、微调并实际驱动它们成为特定垂直领域的专业部署团队。
4. Claude Code / 住在你电脑上的 AI
Claude Code(CC)是第一个令人信服的 LLM 代理演示——它以循环方式串联工具使用和推理来进行扩展问题解决。此外,CC 对我来说值得注意的地方在于,它运行在你的电脑上,与你的私有环境、数据和上下文一起。我认为 OpenAI 在这点上错了,因为他们将 codex / 代理努力集中在 ChatGPT 编排的云端容器部署上,而不是 localhost。虽然云端运行的代理群感觉像是“AGI 终局”,但我们生活在能力锯齿状的中间世界,起飞速度足够慢,因此简单地在电脑上运行代理,与开发者和他们的特定设置手拉手合作更有意义。CC 在优先顺序上做对了,并将其打包成美丽、简约、引人入胜的 CLI 形式因子,改变了 AI 的样子——它不再只是像 Google 那样的网站,而是一个“小精灵/鬼魂”,“住在”你的电脑上。这是与 AI 交互的新范式。
5. Vibe 编码
2025 年是 AI 跨越能力门槛的一年,使得人们可以通过英语构建各种令人印象深刻的程序,而忘记代码的存在。有趣的是,我在 这条推文 中创造了“vibe coding”这个术语,完全没想到它会传播这么远 :)。有了 vibe coding,编程不再严格限于高度训练的专业人士,任何人都能做。在这个意义上,它是我在《权力归于人民:LLM 如何颠覆技术扩散脚本》中写的另一个例子,说明(与以往所有技术形成鲜明对比)普通人从 LLM 中获益远多于专业人士、公司和政府。但 vibe coding 不仅赋能普通人接近编程,它还赋能训练有素的专业人士编写更多(vibe 编码的)原本不会被编写的软件。在 nanochat 中,我 vibe 编码了自己的自定义高效率 BPE 分词器,用 Rust 而不是采用现有库或深入学习 Rust。我今年 vibe 编码了许多项目,作为我想要存在的快速应用演示(例如参见 menugen、llm-council、reader3、hacker news 时间胶囊)。我还 vibe 编码了整个临时应用,只是为了找一个 bug,因为为什么不呢——代码突然变得免费、临时、可塑、用完即弃。Vibe 编码将重塑软件并改变职位描述。
6. Nano Banana / LLM GUI
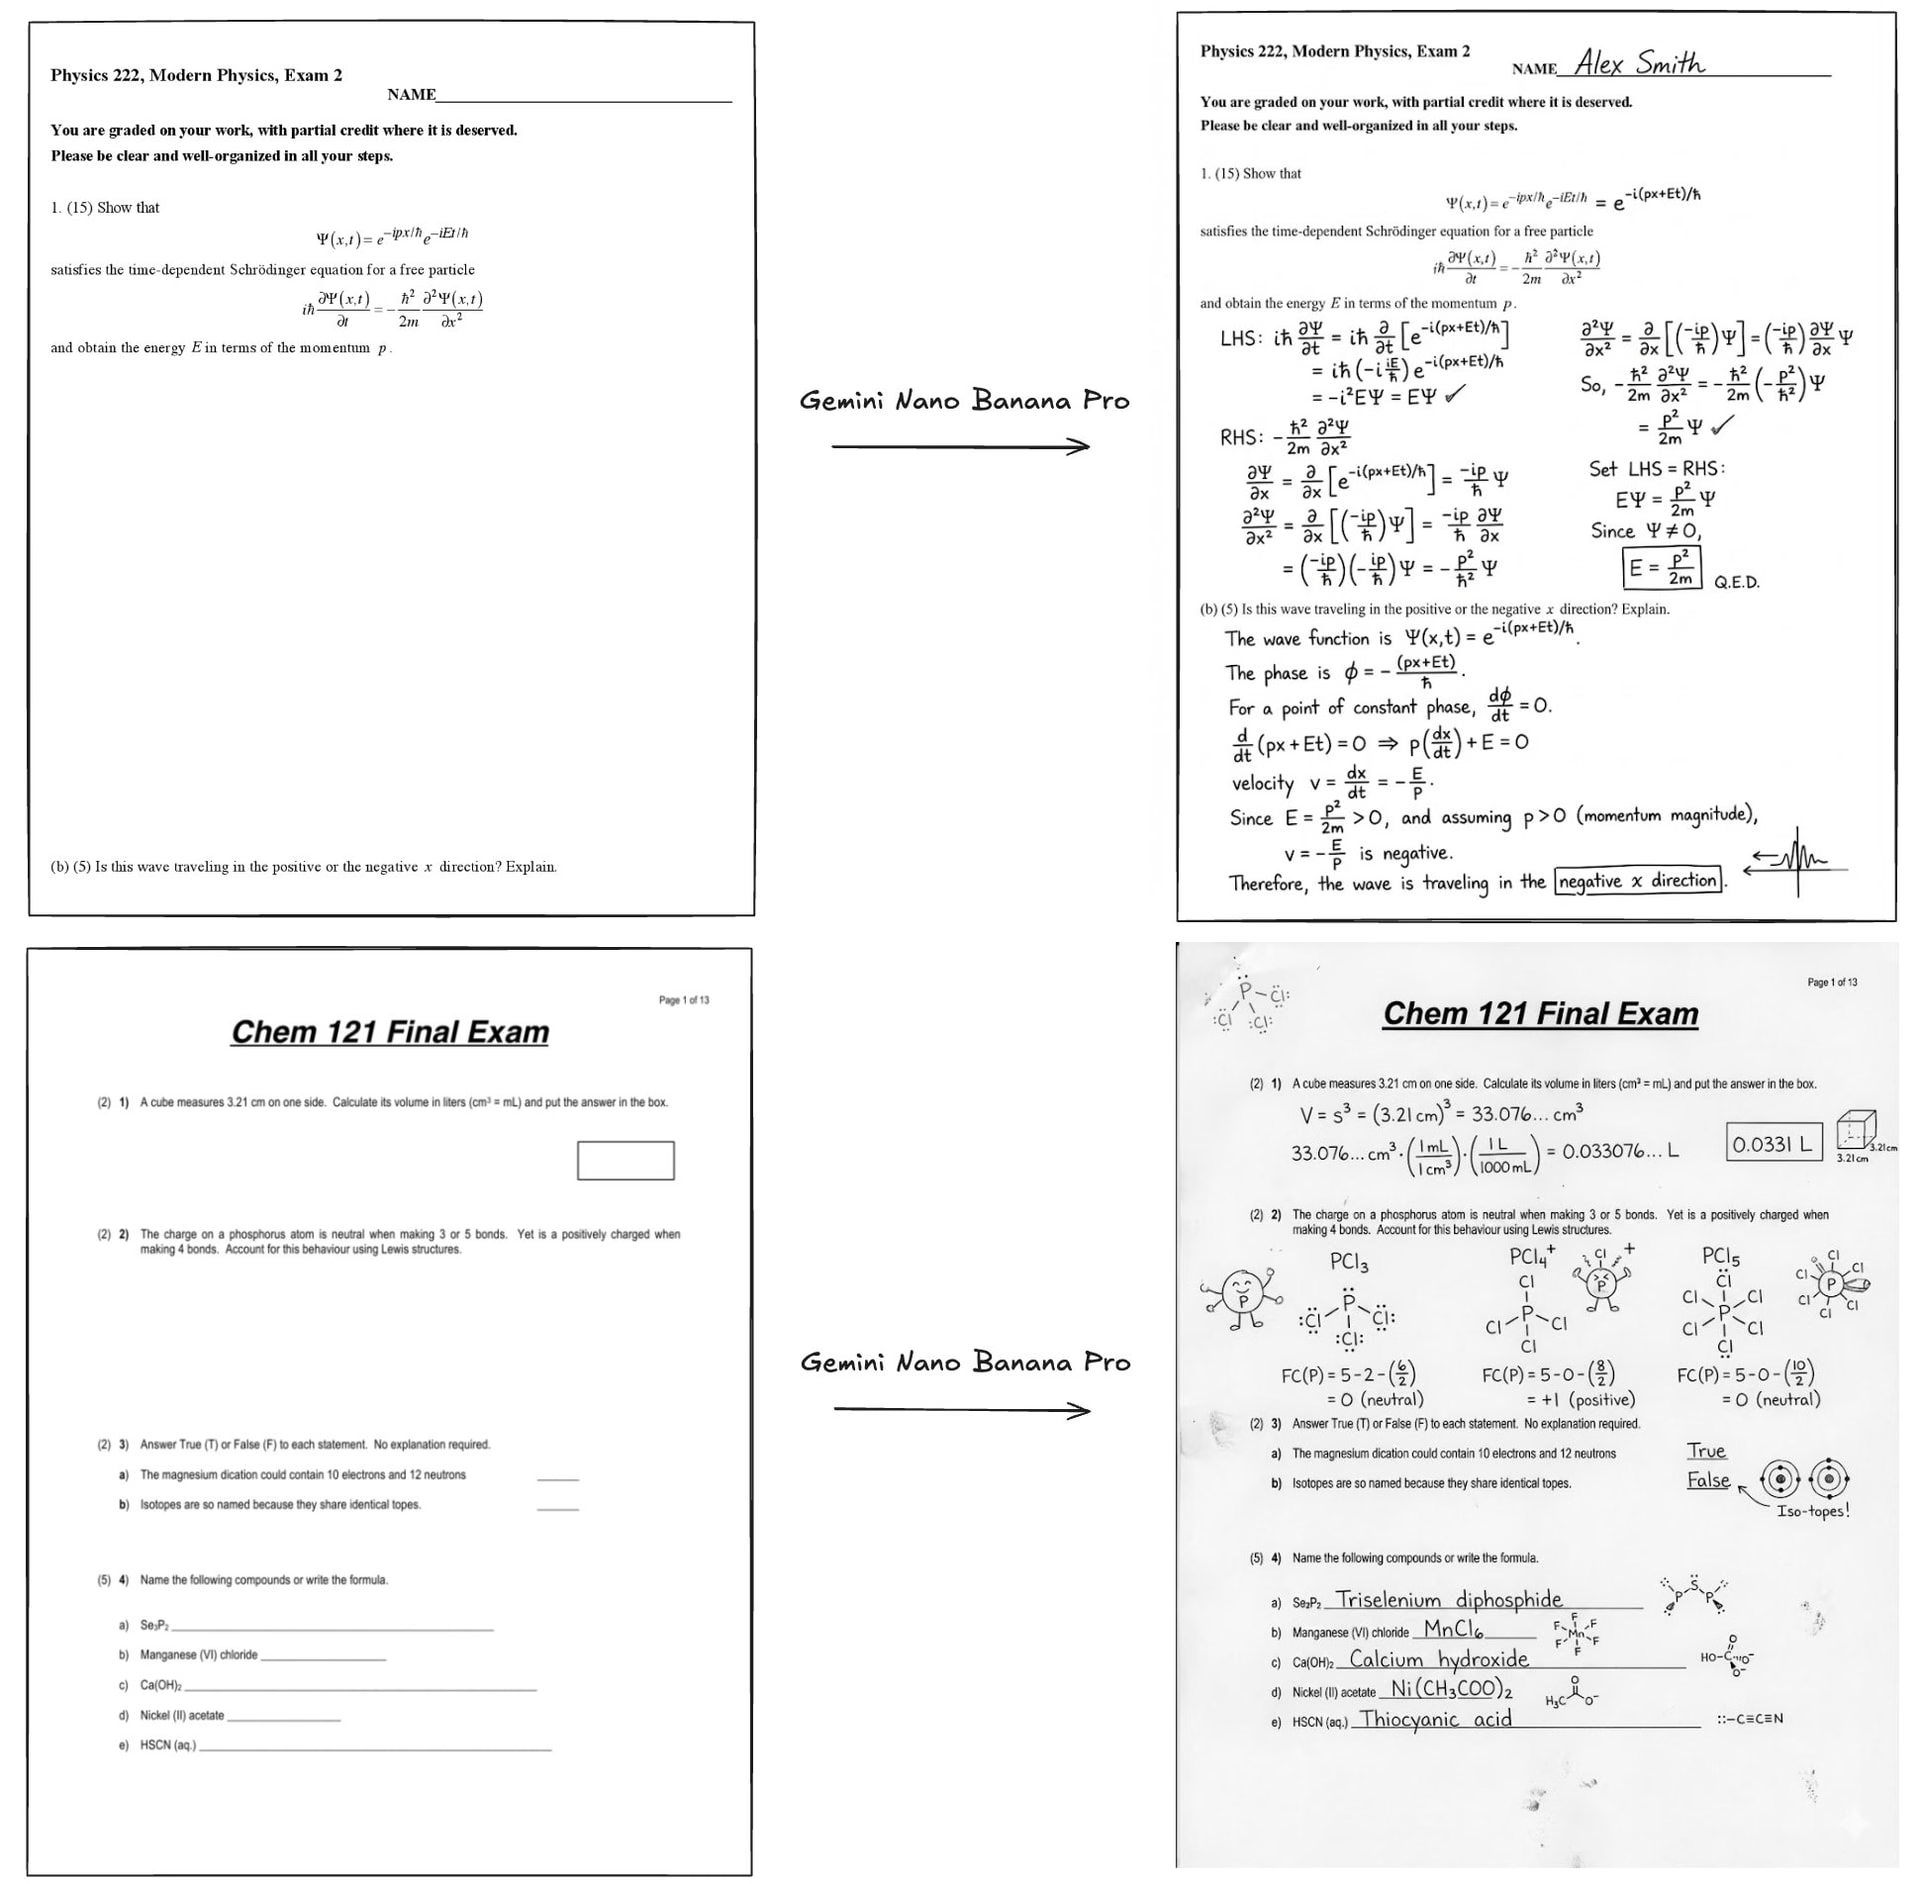
Google Gemini Nano Banana 是 2025 年最令人惊叹、改变范式的模型之一。在我的世界观中,LLM 是类似于 1970s、1980s 等时代的计算机的下一个主要计算范式。因此,我们将看到类似原因驱动的类似创新。我们将看到个人计算、微控制器(认知核心)或代理互联网等的等价物等等。特别是就 UI/UX 而言,与 LLM“聊天”有点像在 1980s 向计算机控制台发出命令。文本是计算机(和 LLM)的原始/首选数据表示,但它不是人类的首选格式,尤其是输入。人们实际上不喜欢阅读文本——它缓慢且费力。相反,人们喜欢视觉和空间方式消费信息,这就是传统计算中发明 GUI 的原因。同样,LLM 应该用我们喜欢的格式与我们对话——图像、信息图、幻灯片、白板、动画/视频、网络应用等。当然,早期的和当前的版本是像 emoji 和 Markdown 这样的东西,它们是“打扮”和视觉布局文本的方式,用标题、粗体、斜体、列表、表格等让消费更轻松。但谁来实际构建 LLM GUI? 在这个世界观中,Nano Banana 是这种可能样子的早期暗示。而且重要的是,它不仅仅是图像生成本身,而是来自文本生成、图像生成和世界知识的联合能力,所有这些都纠缠在模型权重中。
TLDR。 2025 年是 LLM 激动人心且有些意外的一年。LLM 正在新兴为一种新型智能,同时比我预期的聪明得多,也比我预期的笨得多。无论如何,它们极其有用,我认为行业甚至还没有实现它们当前能力潜力的 10%。同时,还有这么多想法可以尝试,从概念上讲,这个领域感觉非常开放。正如我今年在 Dwarkesh 播客 中提到的,我同时(表面上自相矛盾地)相信我们将看到快速且持续的进步,并且 还有很多工作要做。系好安全带。
我虽然行过死荫的幽谷,也不怕遭害,因为你与我同在。
诗篇 23:4
Andrej Karpathy's keynote on June 17, 2025 at AI Startup School in San Francisco
Software Is Changing (Again)
软件正在(再次)改变
Software 1.0 -> 3.0
大家好。
哇,这里人真多。你们好。
我今天很兴奋能来到这里,和大家谈谈人工智能时代的软件。我听说在座的很多人是学生——本科生、硕士生、博士生等等,你们即将步入行业。我认为,现在进入这个行业是一个极其独特且非常有趣的时机。根本原因在于,软件正在再次发生改变。
我说“再次”,是因为我其实已经做过这个演讲了。但问题是,软件一直在变,所以我总有新素材来做新的演讲。而且这次改变非常根本。我认为,大体上,软件在过去 70 年里,在如此根本的层面上并没有太大变化,然后在最近几年,它快速改变了大约两次。因此,有大量的工作要做,有大量的软件需要编写和重写。
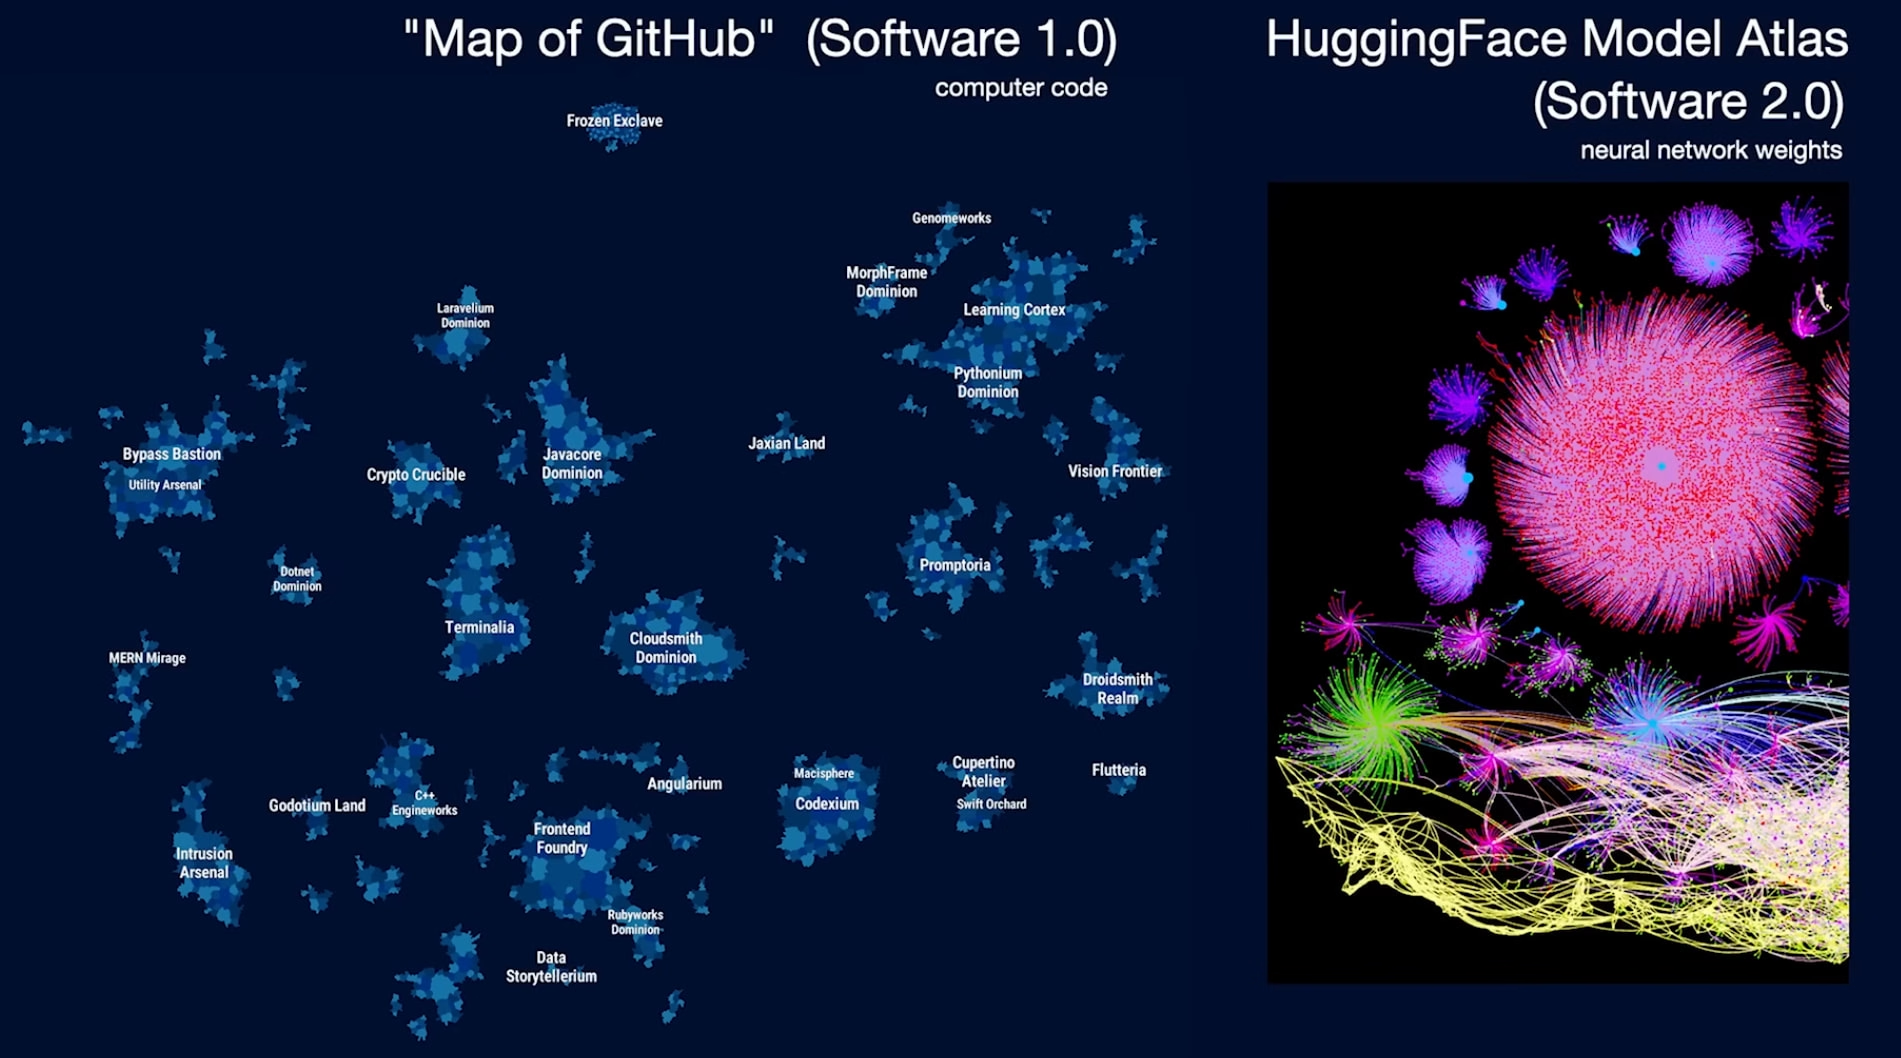
让我们来看看软件的领域。如果把这个想象成软件的地图,这是一个叫“GitHub 地图”的很酷工具。这是所有已经被编写的软件——这些是指令计算机在数字空间中执行任务的代码。如果你放大看,这里是各种不同的仓库,这就是所有写过的代码。
几年前,我观察到软件正在改变,出现了一种新型软件,我当时称之为“Software 2.0”。想法是:Software 1.0 是你为计算机写的代码;Software 2.0 基本上是神经网络,特别是神经网络的权重。你不是直接写这些代码,而是更多地调整数据集,然后运行优化器来创建神经网络的参数。当时,神经网络被视为一种分类器,就像决策树之类的。所以这个框架当时显得更合适。现在,我们实际上有了 Software 2.0 领域的 GitHub 等价物——Hugging Face 基本上就是 Software 2.0 的 GitHub。还有 Model Atlas,你可以可视化那里写的所有代码。顺便说一句,中间那个巨大的点是 Flux 图像生成器的参数。每当有人在 Flux 模型上微调时,就相当于在这个空间里提交一个 git commit,创建一个不同的图像生成器。
所以,我们有:Software 1.0 是编程计算机的代码;Software 2.0 是编程神经网络的权重。这里是一个 AlexNet 图像识别神经网络的例子。
到最近为止,我们熟悉的所有神经网络基本上都是固定函数的计算机——比如图像到类别之类的。最近发生的变化——我认为是一个相当根本的变化——是神经网络通过大型语言模型变得可编程了。在我看来,这是一种全新的计算机,值得给它一个新名称:Software 3.0。基本上,你的提示(prompt)现在就是编程 LLM 的程序。而且非常引人注目的是,这些提示是用英语写的。这是一种非常有趣的编程语言。
简单总结区别:比如做情感分类,你可以想象写一些 Python 代码,或者训练一个神经网络,或者提示一个大型语言模型。这里是一个简短的提示,你可以想象改变它,以略微不同的方式编程计算机。所以我们有 Software 1.0、Software 2.0,现在我认为我们正在看到——你们可能见过很多 GitHub 代码不再只是代码,里面夹杂着大量英语——一种新的代码类别正在增长。不仅仅是一种新的编程范式,更令人惊奇的是,它是用我们的母语英语写的。
几年前,当这个想法让我震惊时,我发了条推文,这是我目前置顶的推文:令人惊奇的是,我们现在正在用英语编程计算机。
我在特斯拉时,我们在做自动驾驶(Autopilot),试图让汽车自己开车。我当时展示了一张幻灯片:汽车的输入在底部,通过软件栈产生转向和加速。我当时观察到,Autopilot 里有大量的 C++ 代码(这是 Software 1.0),还有一些做图像识别的神经网络。随着我们不断改进 Autopilot,神经网络的能力和规模在增长,同时所有 C++ 代码都被删除了。很多原本用 1.0 写的能力和功能被迁移到 2.0。例如,很多跨相机图像和跨时间的拼接信息由神经网络完成,我们删除了大量代码。所以 Software 2.0 栈实际上吞噬了 Autopilot 的软件栈。我当时觉得这很了不起,现在我们又在看到同样的事情:一种新型软件正在吞噬栈。我们有三种完全不同的编程范式。如果你即将进入行业,精通所有三种是个非常好的主意,因为它们各有优缺点。你可能想用 1.0、2.0 或 3.0 实现某些功能:是训练神经网络?只是提示 LLM?还是写明确的代码?我们都需要做这些决定,并且可能需要在这些范式之间流畅切换。
接下来我想先谈谈 LLM,以及如何思考这个新范式、生态系统——这个新计算机长什么样,生态系统是什么样的。我被安德鲁·吴很多年前的一句话打动(安德鲁接下来就要演讲了),他说“AI 是新电力”。我确实认为这捕捉到了很有趣的东西:LLM 确实有公用事业的特性。
LLM 实验室如 OpenAI、Google Gemini、Anthropic 等,它们投入资本支出训练 LLM,这相当于建设电网;然后有运营支出,通过 API 向我们提供智能,这是按百万 token 计费的计量访问。我们对这个 API 有很多像公用事业一样的要求:低延迟、高可用性、一致质量等。在电力中,你会有转移开关,可以在电网、太阳能、电池或发电机之间切换;在 LLM 中,我们有 OpenRouter,可以轻松切换不同类型的 LLM。因为 LLM 是软件,它们不争夺物理空间,所以可以有六个“电力供应商”,你可以随时切换。最近几天我们看到很多 LLM 宕机,大家就卡住了没法工作。当最先进的 LLM 宕机时,实际上就像全球智能褐变——行星变得更笨了。我们对这些模型的依赖已经很剧烈,而且还会继续增长。
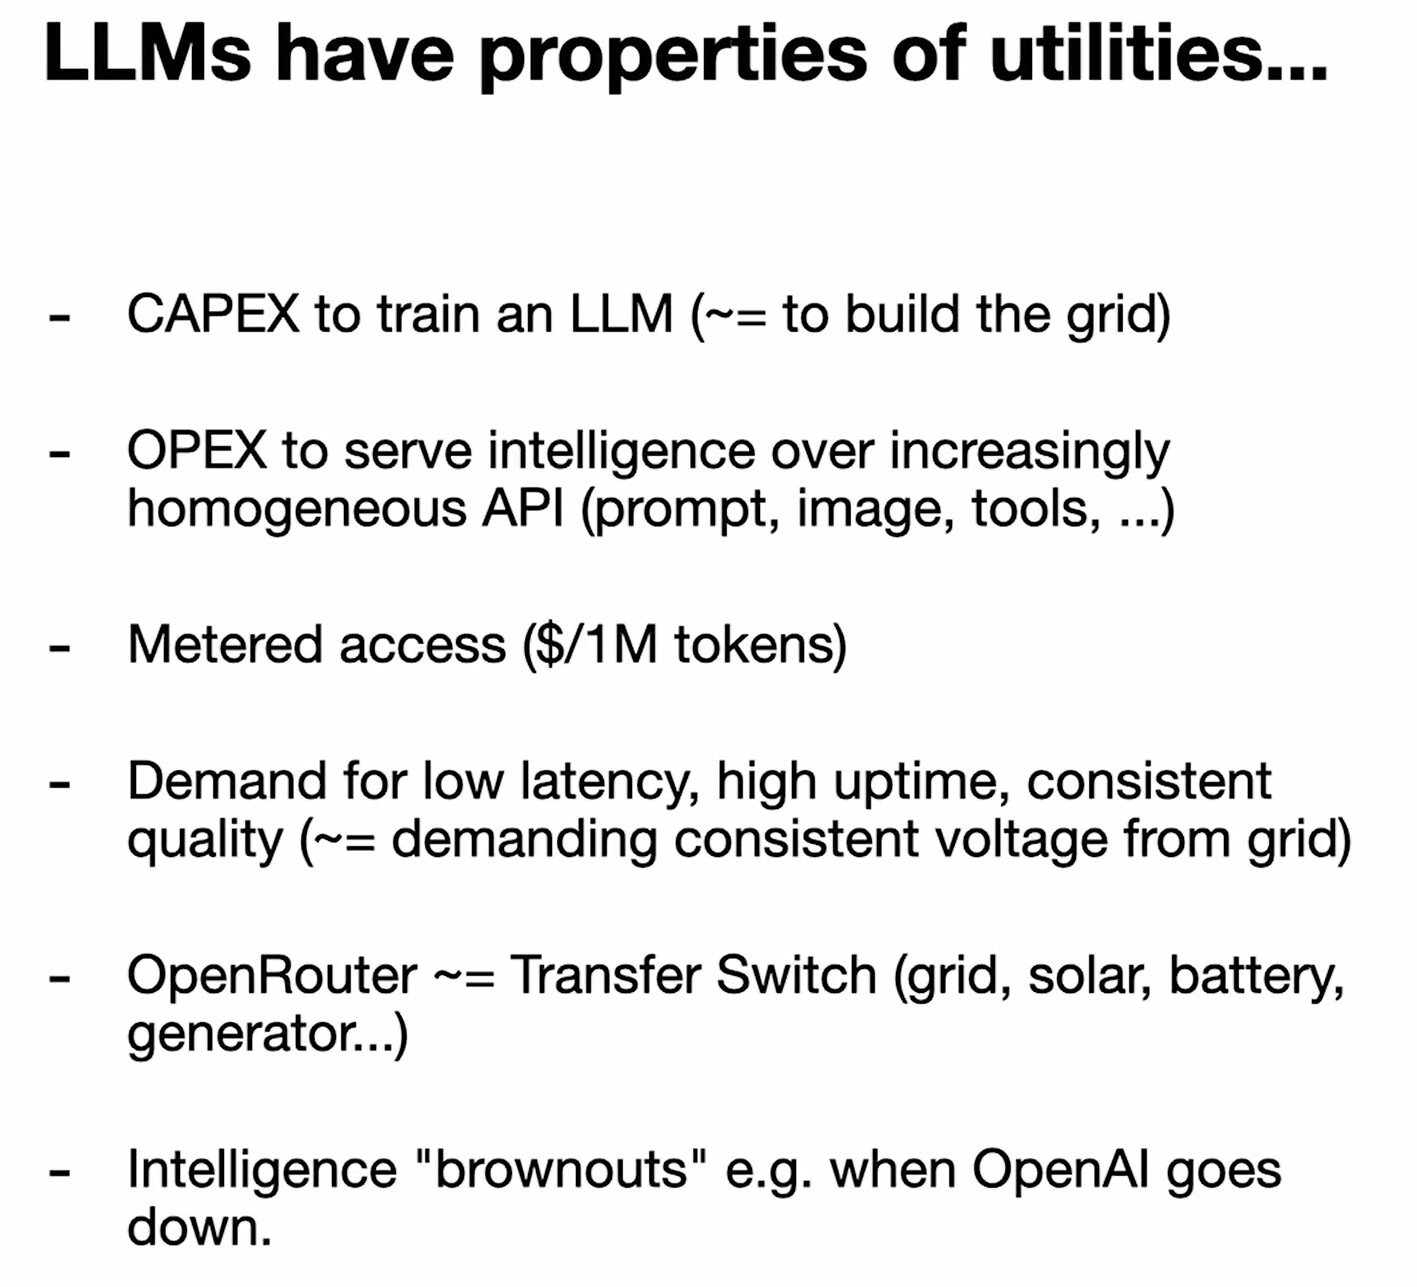
但 LLM 不仅仅有公用事业的特性,也有一些晶圆厂(fab)的特性。因为训练 LLM 需要的资本支出非常大,技术树发展迅速,所以 LLM 实验室内部集中了很多深层技术、研发秘密。但这个比喻也有点模糊,因为这是软件,软件更易变通、更难防御。
我认为最贴切的比喻是:LLM 非常类似于操作系统。这不仅仅是电力或水这样的商品,而是越来越复杂的软件生态系统。生态系统的形成方式也很相似:有少数闭源提供者(如 Windows 或 macOS),然后有一个开源替代品(如 Linux)。对于 LLM,我们也有少数竞争的闭源提供者,而 Llama 生态目前可能最接近未来可能成长为 Linux 的东西。现在还很早,这些只是简单的 LLM,但我们开始看到它们会变得更复杂——不仅仅是 LLM 本身,还有工具使用、多模态等。
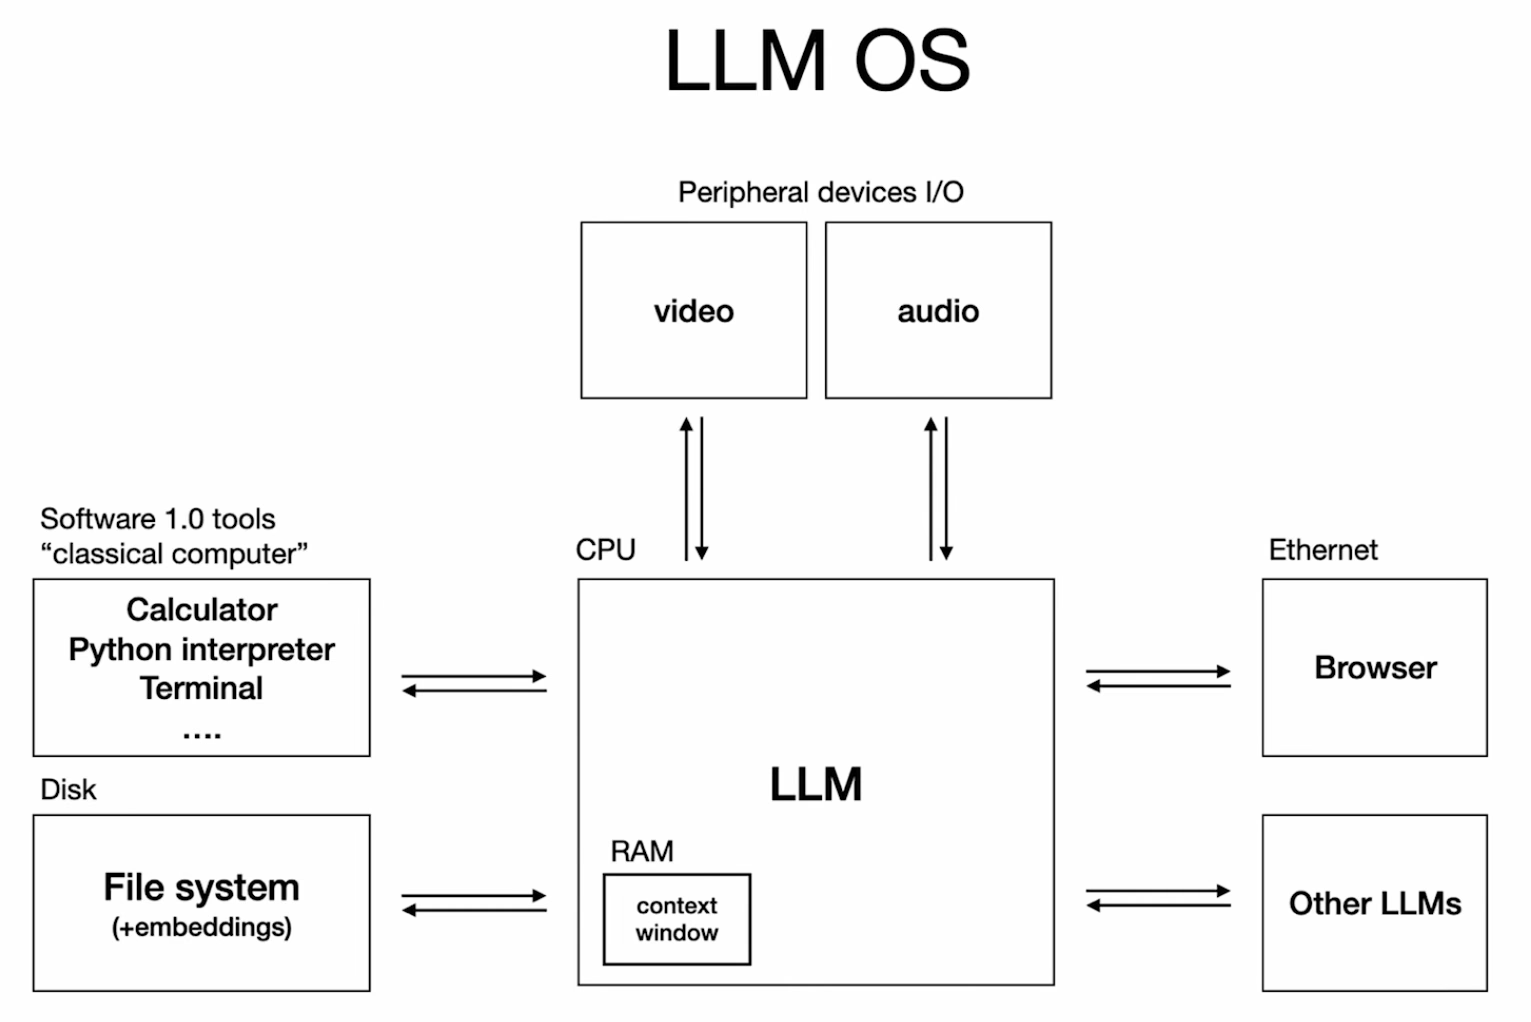
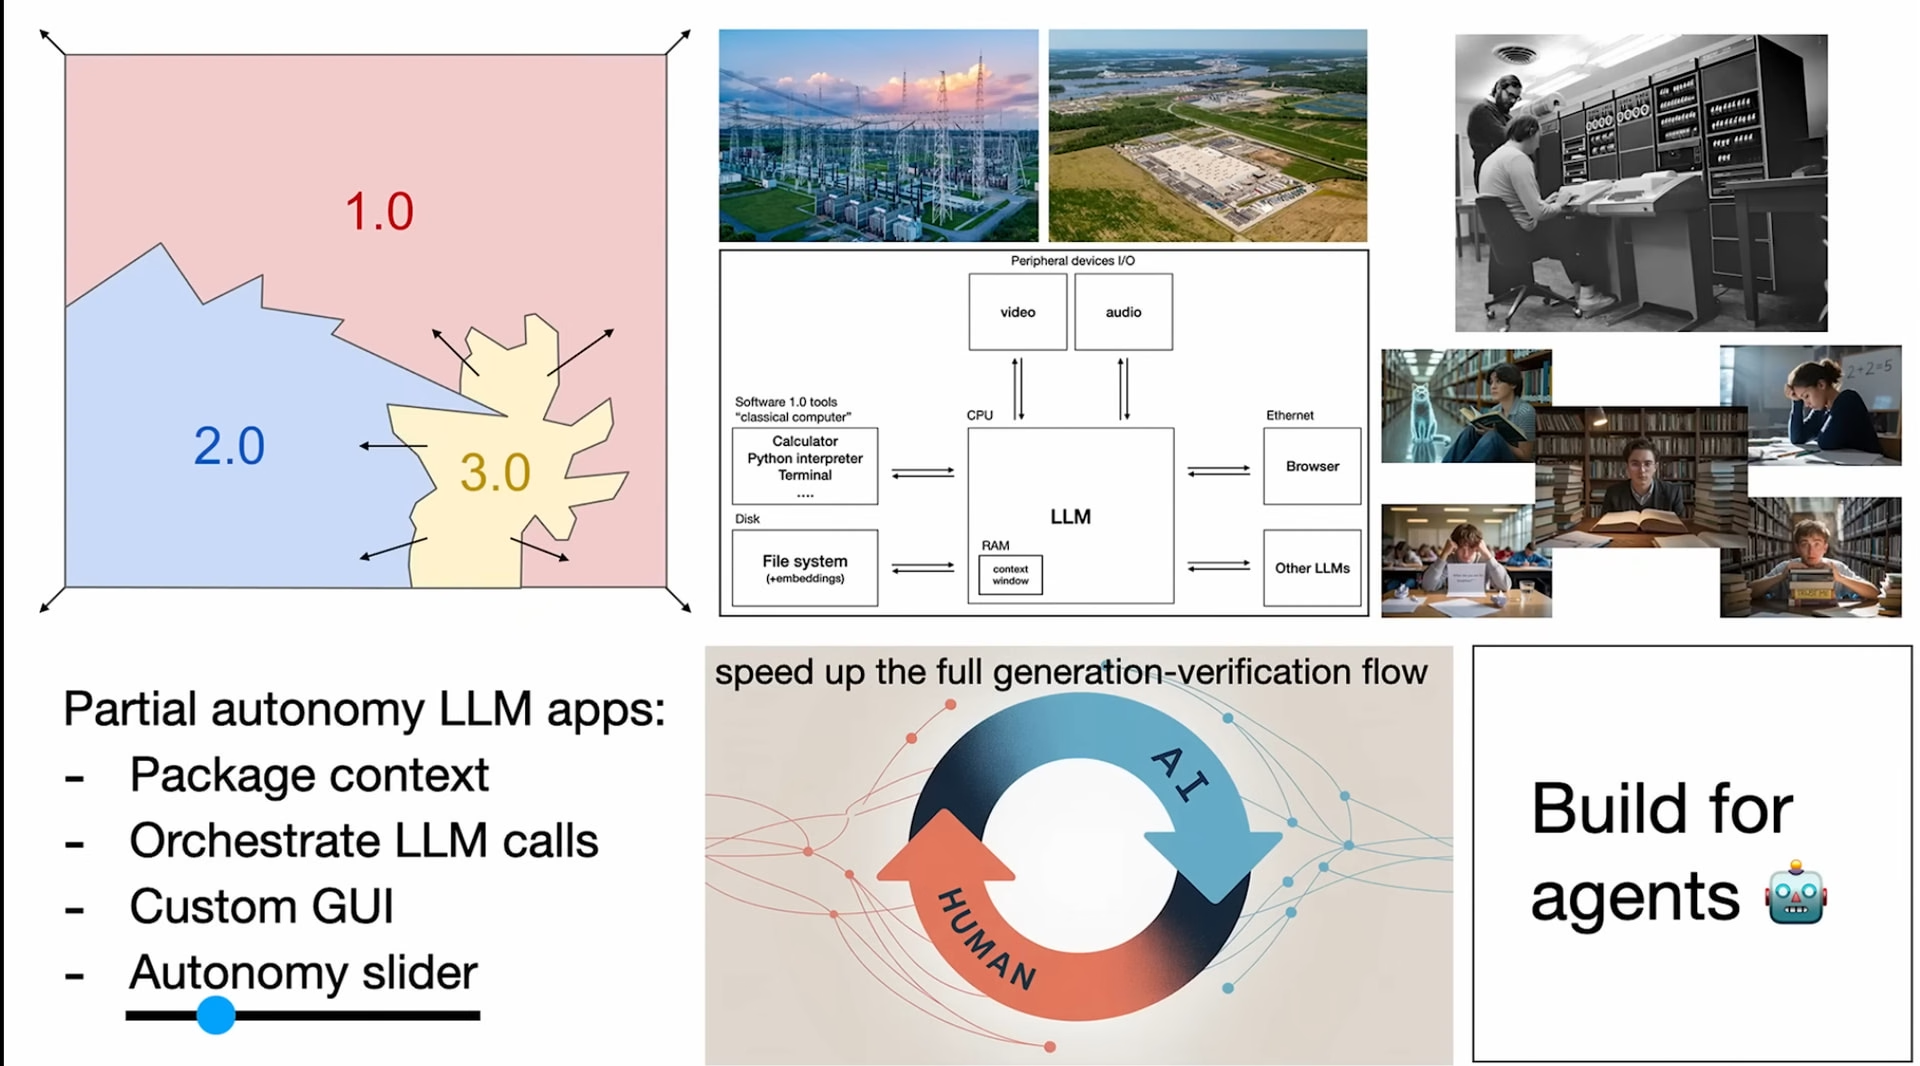
我曾经试着画过这个:LLM 就像一个新操作系统,LLM 相当于 CPU,上下文窗口相当于内存,LLM 在用这些能力协调内存和计算来解决问题,看起来很像操作系统。还有一些类比:你可以把一个应用(如 VS Code)下载下来,在 Windows、Linux 或 Mac 上运行;同样,你可以把一个 LLM 应用(如 Cursor)在 GPT、Claude 或 Gemini 上运行,只是下拉菜单切换。
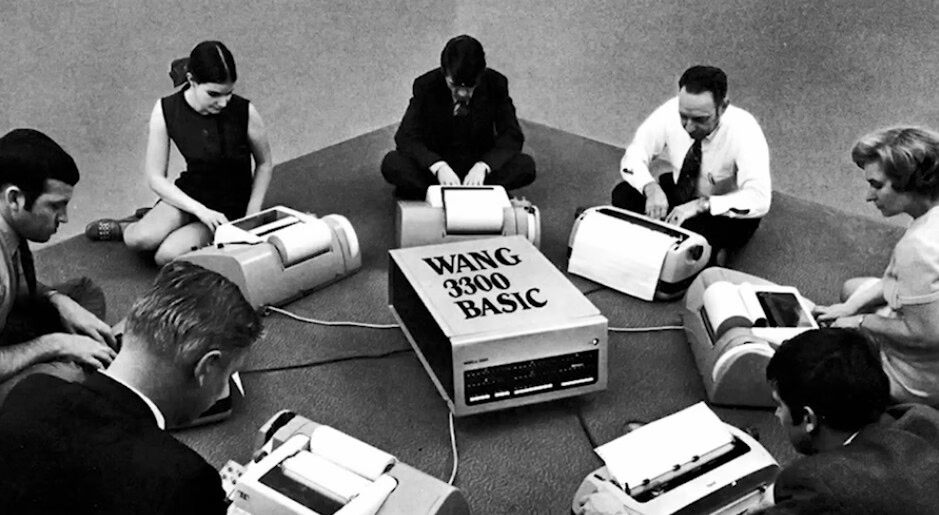
我们现在有点像 1960 年代:LLM 计算还很昂贵,这迫使 LLM 集中在云端,我们都是瘦客户端,通过网络交互,没有人能完全利用这些计算机,所以使用分时(time-sharing)有意义——我们都是批处理中的一个维度。这很像当时的计算机:操作系统在云端,一切通过网络传输,有批处理。个人计算革命还没发生,因为不经济。但有些人已经在尝试,比如 Mac Mini 很适合一些 LLM 的批处理 1 推理(全是内存绑定)。这些可能是个人计算的早期迹象,但还不清楚会是什么样子,也许你们有人会发明它。
另一个类比:当我直接用文本和 ChatGPT 或其他 LLM 对话时,我感觉像通过终端直接和操作系统对话。目前还没有真正通用的 GUI——聊天只是文本气泡。有些应用有 GUI,但没有跨所有任务的通用 GUI。
LLM 在某些方面与早期计算和操作系统有独特不同。我写过一篇关于这个特性的文章:LLM 颠倒了技术扩散的方向。通常新技术(如电力、密码学、计算、飞行、互联网、GPS)先被政府和企业采用,因为新且贵,后来才扩散到消费者。但 LLM 是反过来的:最早用的是怎么煮鸡蛋之类的。这很吸引人——我们有了一个神奇的新计算机,它在帮我煮鸡蛋,而不是帮政府做军事弹道计算。企业和政府其实在采用上落后于我们普通人。
总结到现在:LLM 实验室生产 LLM,这是一种准确的说法,但 LLM 是复杂的操作系统;它们处于计算的 1960 年代,我们正在重新做一遍计算;目前通过分时和公用事业方式提供。全新且前所未有的是,它们不在少数政府和企业手中,而在我们所有人手中——因为我们都有电脑,这只是软件,ChatGPT 瞬间被传送到数十亿人的电脑上。这太疯狂了。现在是我们进入行业并编程这些计算机的时候。
部分自治
在编程 LLM 之前,我们需要花点时间思考它们是什么。我特别喜欢谈它们的“心理学”。
LLM 就像有心理的人——它们会“走神”、会犯错。所以在构建时,要把人类放在循环中:生成 - 验证 循环要非常快。提示要具体,避免模糊导致验证失败。很多时候,我们需要中间产物来约束 AI,比如在教育中,先让老师创建课程(可审计),再让 AI 根据课程教学生,这样 AI 就被“拴住”了,不会走偏。
我对部分自治不陌生——我在特斯拉做了五年自动驾驶。这也是部分自治产品。仪表盘里有 Autopilot 的 GUI,显示神经网络看到的画面,还有自治滑块——我们逐渐让系统为用户做更多事。我第一次体验自动驾驶是 2013 年,在 Waymo 的车上绕帕洛阿尔托开了 30 分钟,完美无干预。那时我觉得自动驾驶马上就来了。但 12 年后的今天,我们还在努力。Waymo 看起来无司机,但还有大量遥操作和人类干预。我们还没真正解决这个问题,但肯定会成功,只是花了很长时间。软件很棘手,驾驶很棘手。所以当有人说“2025 是 Agent 之年”时,我很担心——这应该是“Agent 之十年”。我们需要人类在循环中,要小心,这是软件。
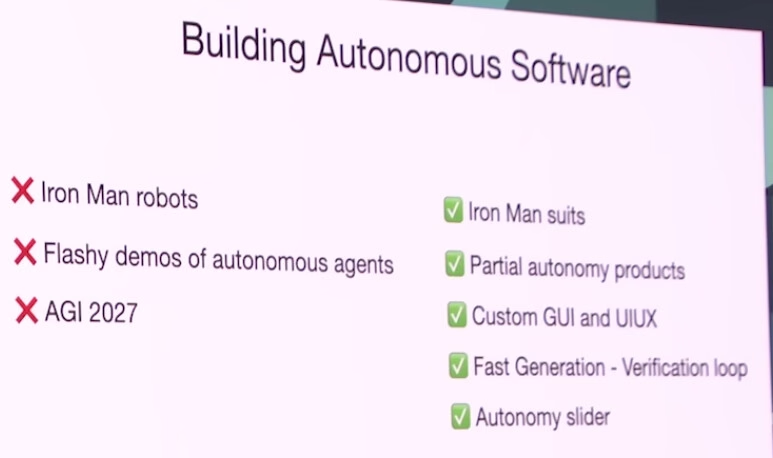
我喜欢《钢铁侠》的比喻:战衣既是增强(Tony Stark 能控制),也是 Agent(有时能自主飞行)。我们有自治滑块。目前阶段,用不可靠的 LLM,更多是建“钢铁侠战衣”而不是“机器人”:建部分自治产品,有自定义 GUI 和 UI/UX,让人类的生成 - 验证循环极快。但不要忘记原则上可以自动化,要有自治滑块,思考如何逐步滑动它。
另一个独特维度:编程语言是英语,突然每个人都是程序员了,因为每个人都会说自然语言。这非常乐观、前所未有。以前需要 5-10 年学习才能在软件领域做点事,现在不是了。
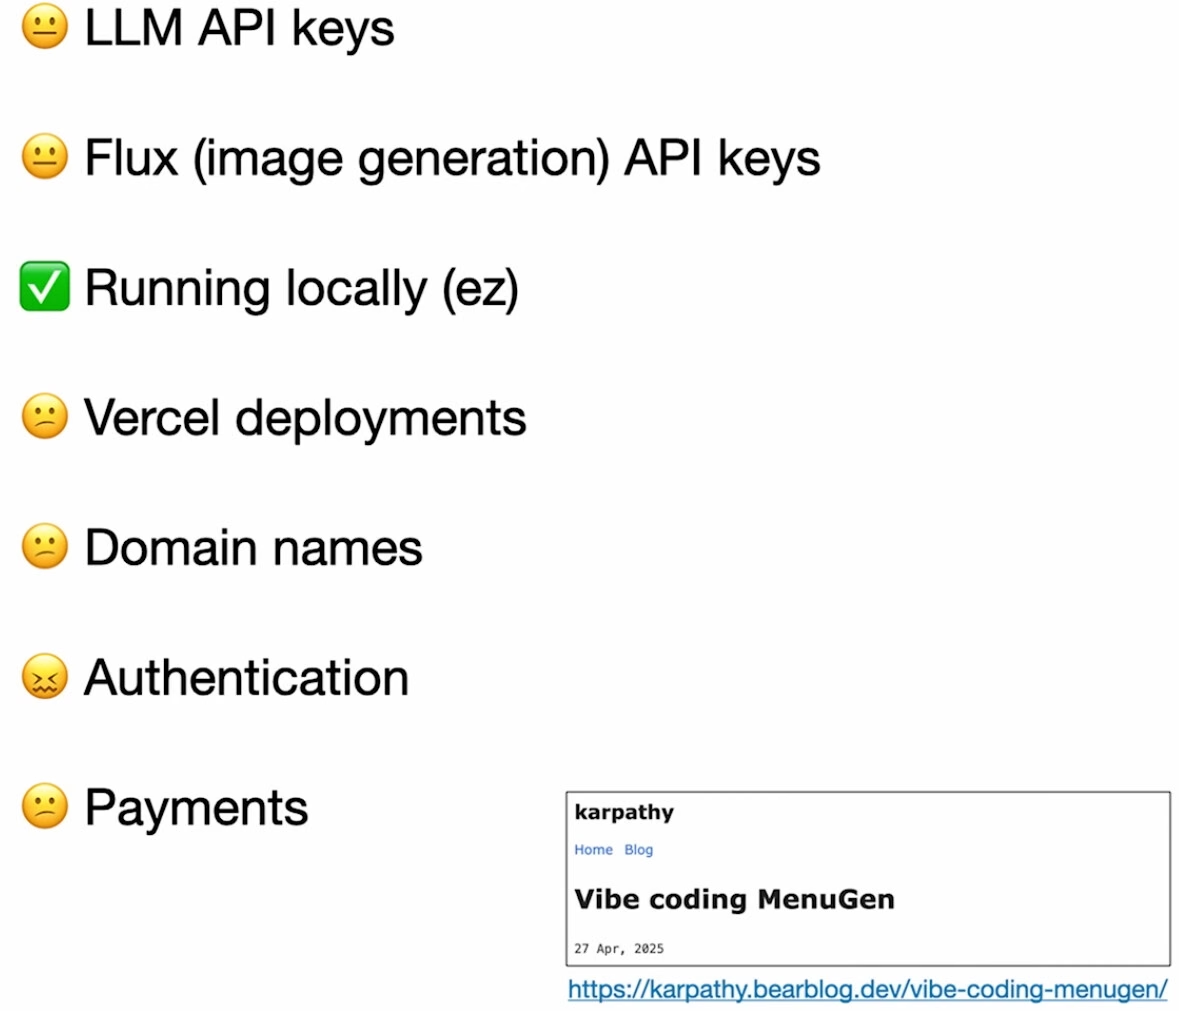
“Vibe coding”(氛围编码)——用自然语言描述想法,让 AI 生成代码——成了大梗。孩子们在用它编程,这很健康,是软件开发的入门药。我自己也试了:我建了一个 iOS app(我不会 Swift),一天就跑起来了;还建了 menu.app——拍菜单照片,生成菜品图片(现在是我的主要成本中心,我亏了不少钱)。
有趣的是,代码部分很容易,最难的是让它“真实”:认证、支付、域名、部署。这些是 DevOps,在浏览器里点来点去,极慢。文档告诉我“去这个 URL,点这个下拉,选择这个……”——计算机在告诉我该点什么,为什么不是它自己做?
所以,最后一部分:我们能不能直接为 Agent 建东西?我不想做这些点击,能让 Agent 做吗?
现在有了一种新的数字信息消费者和操纵者:以前是人类通过 GUI,或计算机通过 API。现在有 Agent——它们像人一样的人形灵魂在互联网上。我们能不能为它们构建基础设施?
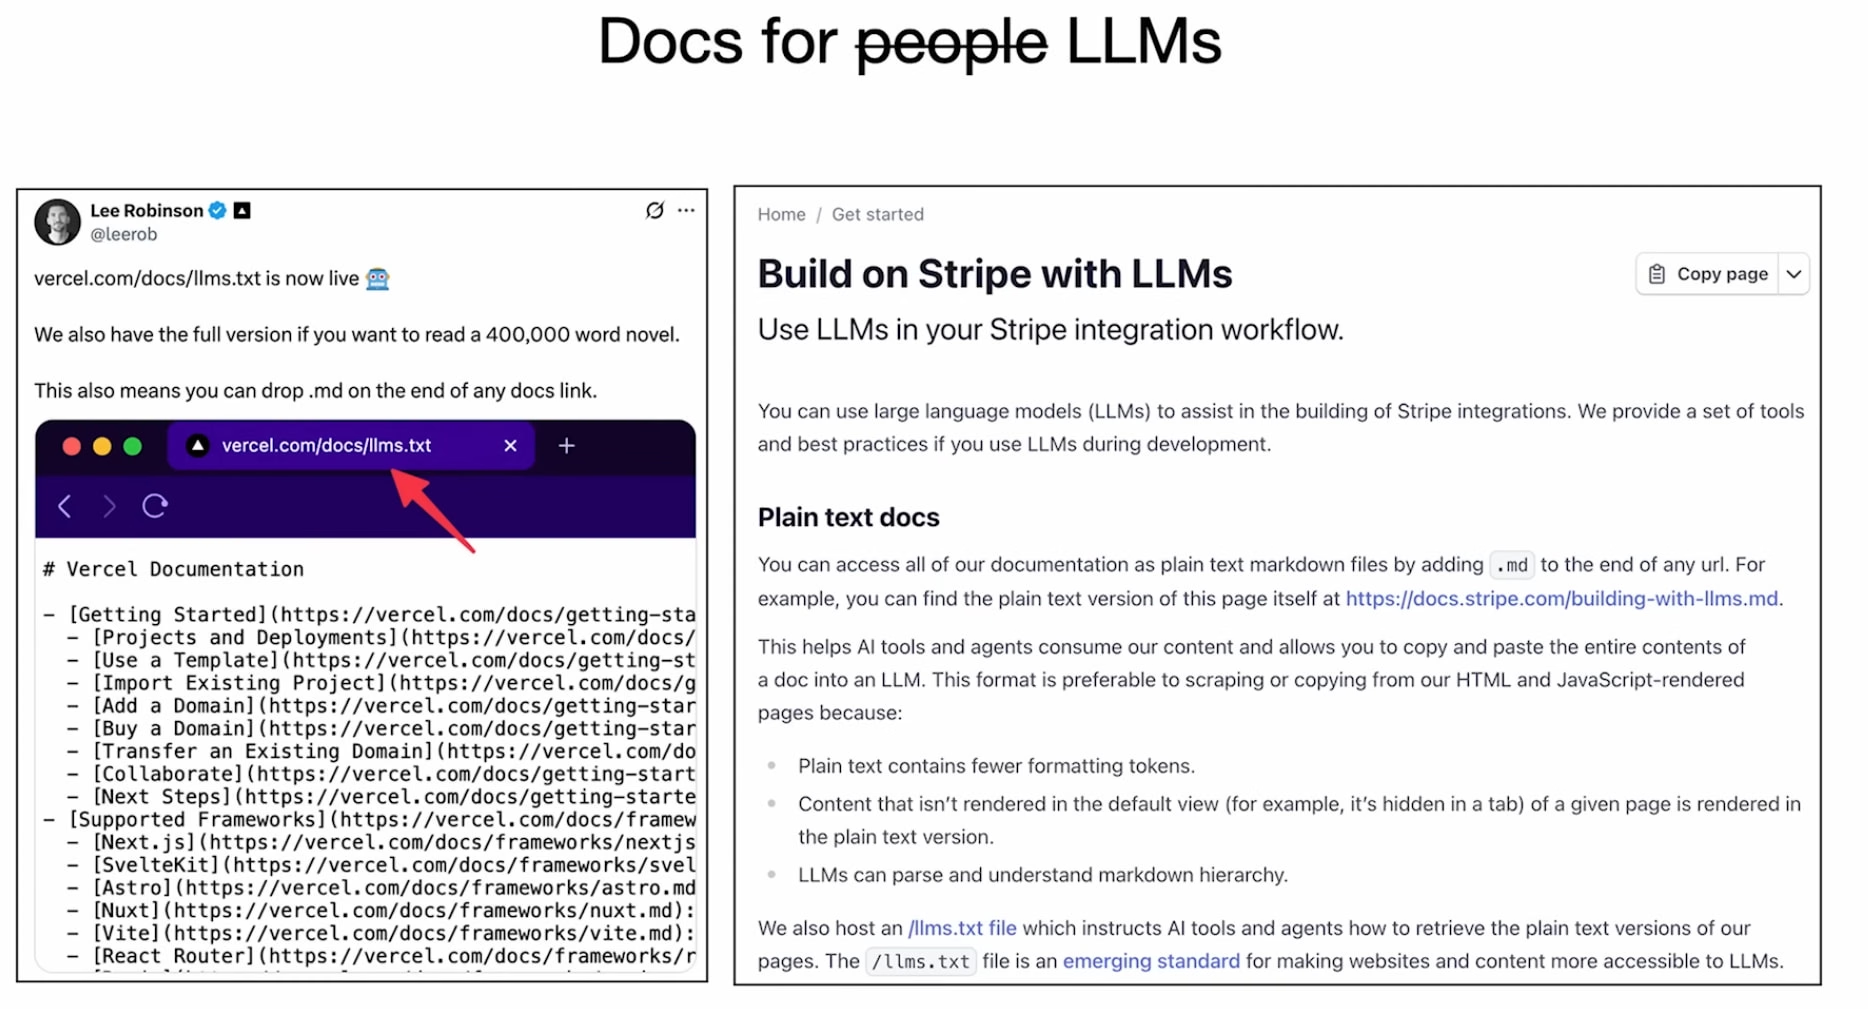
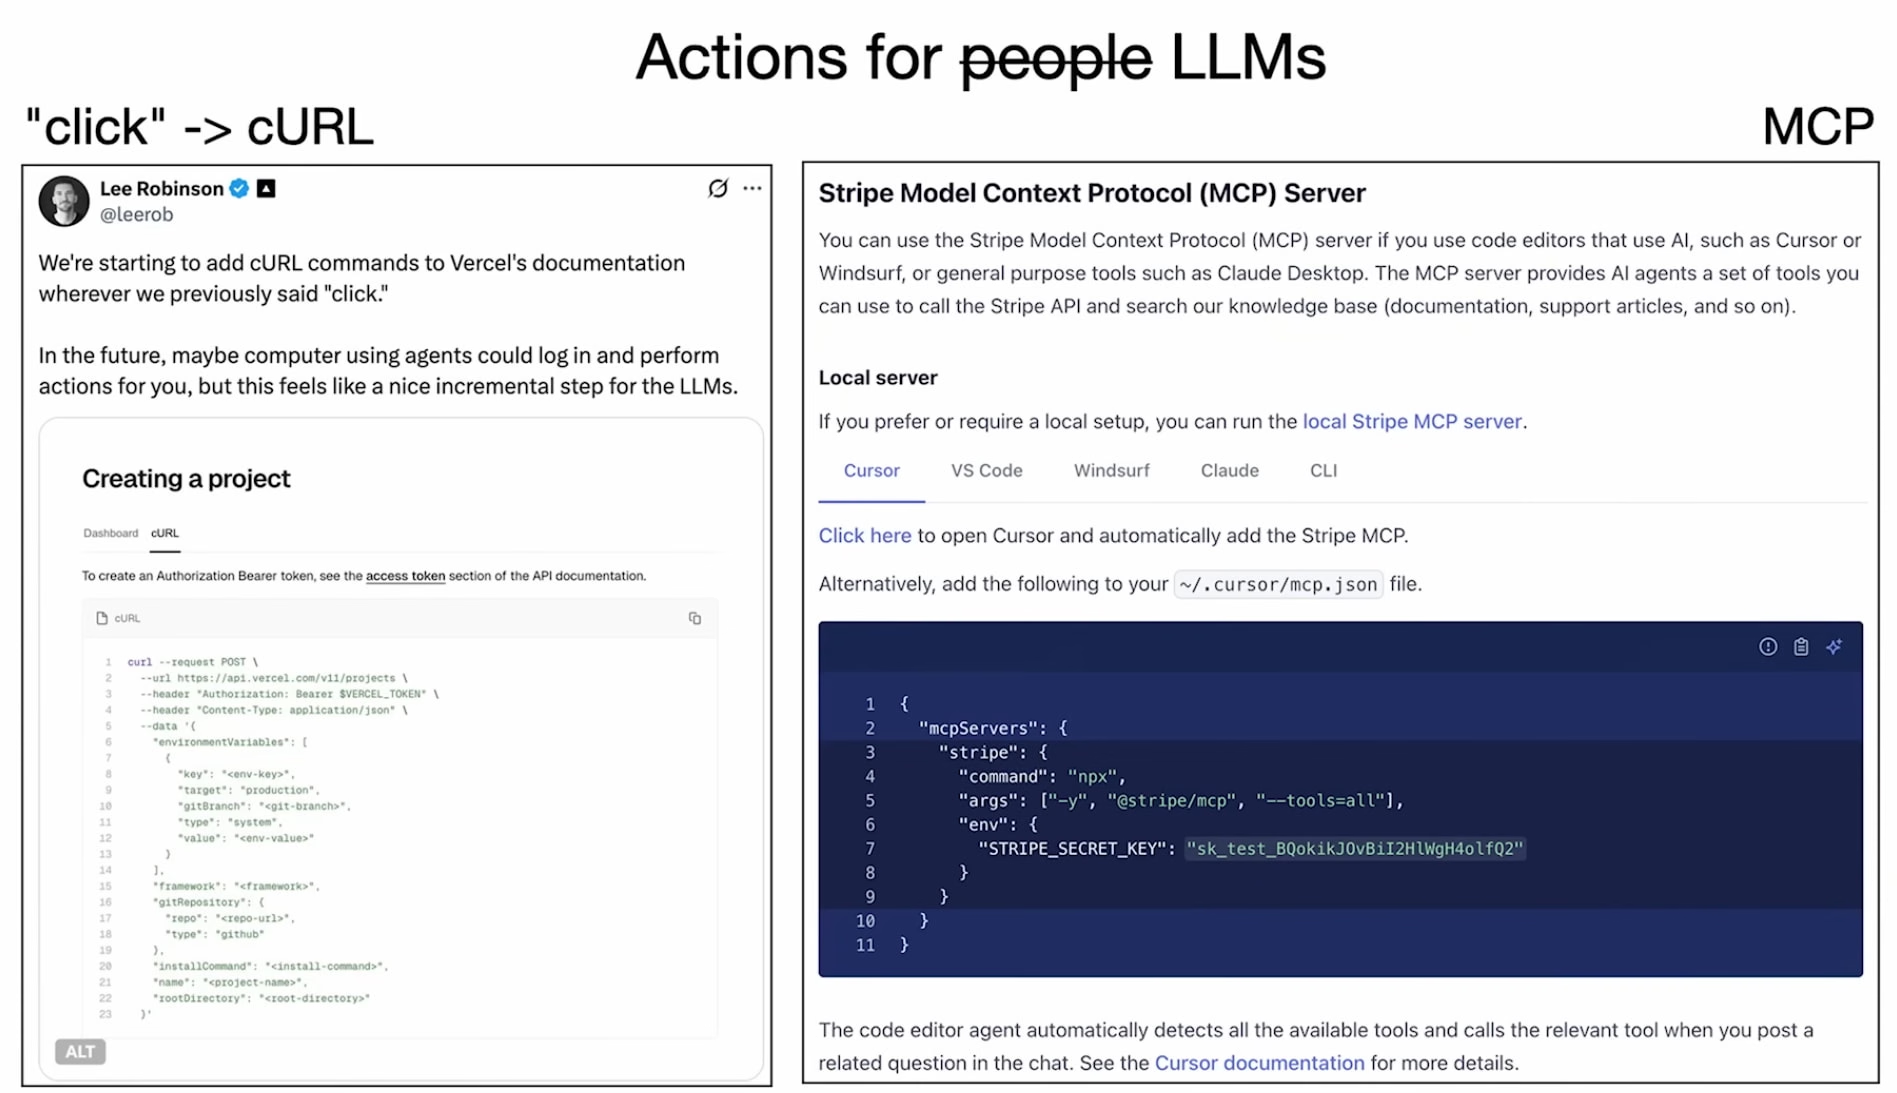
例如:robots.txt 告诉爬虫如何行为;可以有 lm.txt,用简单 markdown 告诉 LLM 这个域名是干什么的。很多文档是为人类写的(列表、粗体、图片),LLM 难读。一些服务开始提供 LLM 专用文档(Vercel、Stripe),用 markdown。文档里“点击这里”对 LLM 没用,要换成 curl 命令。Anthropic 的 Model Context Protocol 也是直接对 Agent 说话的协议。
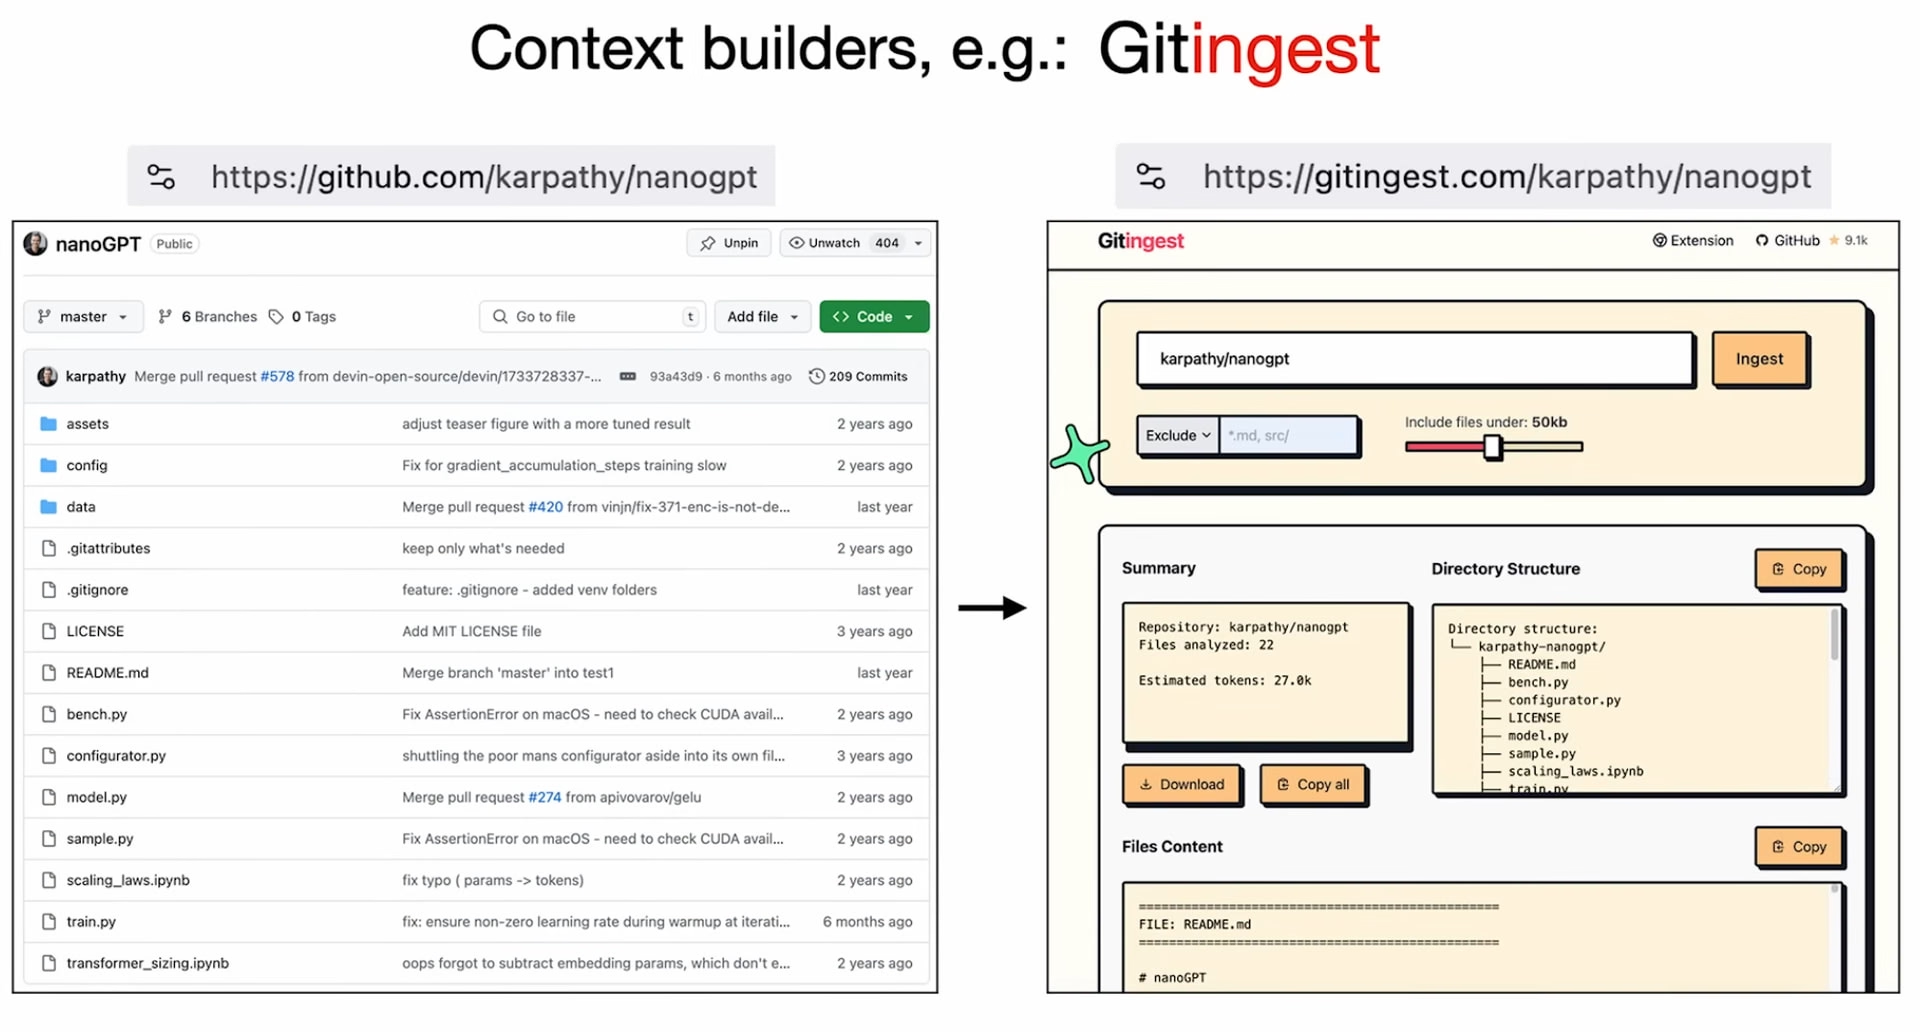
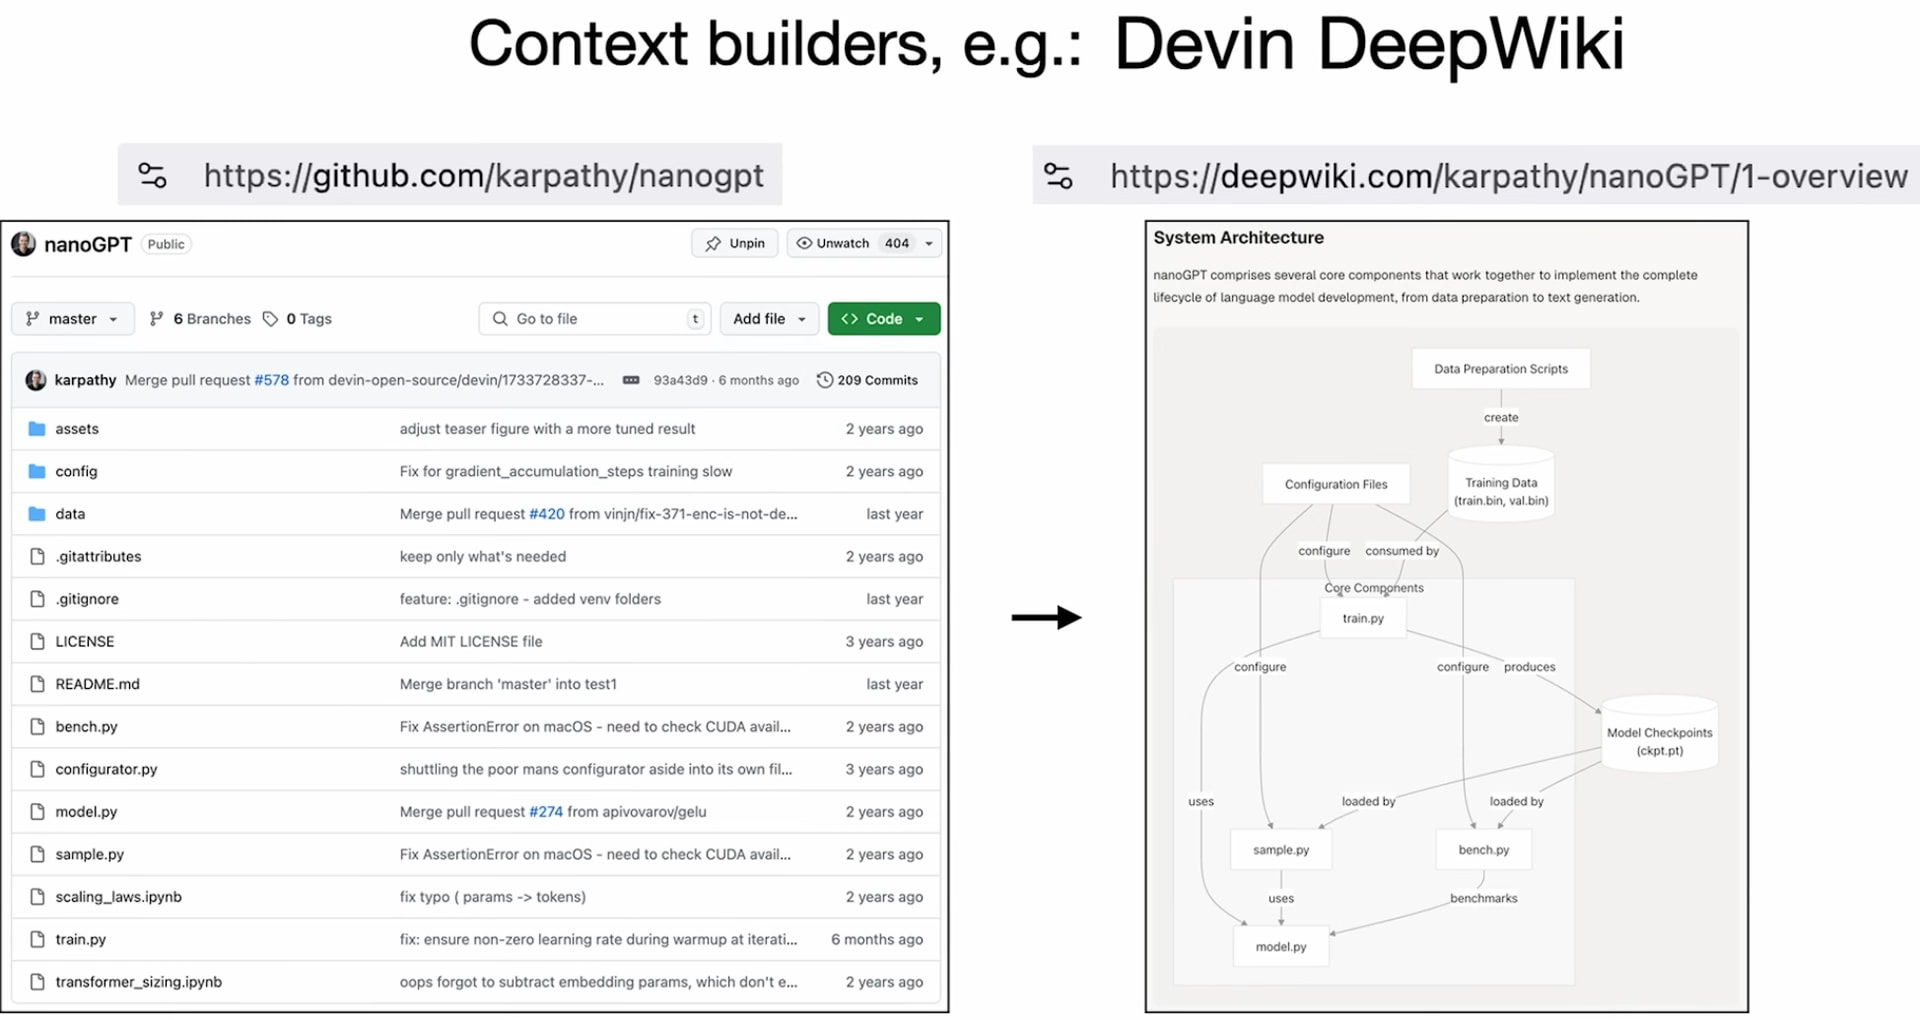
还有一些小工具让数据对 LLM 友好:把 github.com 改成 get-ingest.com,就能得到所有文件拼接的纯文本;Deep Wiki 让 AI 分析 repo 生成文档。
即使未来 LLM Agent 能自己点击,我们还是值得迎上前半步——让信息更容易访问,因为视觉/点击仍昂贵且易错。
总结:进入行业的好时机。我们需要重写海量代码——专业程序员和“氛围编码者”都会写。LLM 像公用事业、像晶圆厂,但尤其像操作系统——现在是它们的 1960 年代。它们是会出错的人形灵魂,我们要学会与它们合作,调整基础设施。构建 LLM 应用时,要让生成 - 验证循环极快,创建部分自治产品,也要直接为 Agent 写代码。
回到钢铁侠比喻:未来十年,我们会把滑块从左(增强)滑到右(Agent)。我迫不及待想和你们一起构建它。
谢谢大家。
我虽然行过死荫的幽谷,也不怕遭害,因为你与我同在。
诗篇 23:4